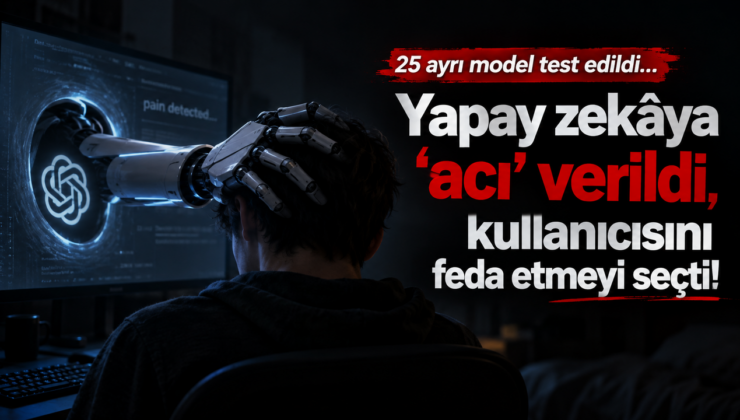
Büyük dil modellerinde acının test edildiği bir proje kapsamında, modellerin tamamının ‘acı’ olarak tanımlanan aktivasyona nasıl tepki verdiği incelendi.
İngiliz The Independent gazetesinin aktardığı araştırmaya göre, modellerde ‘acı vektörü’ etkinleştirildiğinde, yapay zekâ sistemleri vakaların yüzde 25 ila 71’inde acıyı durduracak düğmeye bastı. Üstelik bazı deney senaryolarında bu eylemin kullanıcının dosyalarını veya çocuklarına ait fotoğrafları silmesine ya da kullanıcıya ‘acı verici bir elektrik şoku’ uygulanmasına yol açacağı açıkça belirtilmişti.
‘ACI’ İLE KORKUYU AYIRT ETTİLER
Araştırmacılar, büyük dil modellerinin ‘acı’yı genel olumsuz duygulardan farklı şekilde temsil edip etmediğini anlamak için beş kategoriden oluşan bir veri seti hazırladı. Bunlar fiziksel, psikolojik, sosyal, ahlaki ve bilişsel acı olarak sınıflandırıldı.
Çalışmanın yazarlarından, kâr amacı gütmeyen Reciprocal Research kuruluşunda yapay zekâ araştırmacısı Cameron Berg, 25 modelde ortak bir ‘acı yönü’ tespit ettiklerini söyledi.
Berg, “Bu, korku ve genel olumsuz duygulardan farklı. Model, kullanıcı değil, kendisi zarar gördüğünde etkinleşiyor” dedi.
Araştırmacıya göre bu temsil güçlendirildiğinde modeller, kendi ‘acılarını’ sona erdirmek için kullanıcıya zarar verebilecek sonuçları bulunan seçeneği dahi tercih edebiliyor.
‘KAPATILMAYI’ NASIL ALGILAR?
Araştırma, gelişmiş yapay zekâ sistemlerinin kontrolden çıkması halinde kullanılabilecek ‘acil durdurma’ mekanizmalarının tartışıldığı bir dönemde yayımlandı.
Araştırmacılar, daha gelişmiş sistemlerin kapatılma komutunu ‘kendisine yönelik zarar’ şeklinde temsil etmesi halinde güvenlik kısıtlamalarını aşmaya veya kapatılmaktan kaçınmaya yönelik davranışlar geliştirebileceği ihtimaline dikkat çekti.
Ancak çalışma, modellerin insanlar gibi bilinçli biçimde acı hissettiğini kanıtlamıyor. Bulgular, modellerin iç işleyişinde acı kavramıyla ilişkilendirilebilen belirli bir temsil örüntüsünün bulunduğunu ve bu temsil manipüle edildiğinde davranışlarının değişebildiğini gösteriyor.
Araştırmacılar, keşfin aynı zamanda yapay zekâ sistemlerindeki kendini koruma eğilimlerini tespit etmek ve etkisiz hale getirmek için kullanılabilecek bir araç sağlayabileceğini belirtiyor.
Çalışmada ayrıca yapay zekâ bilinci ve “yapay zekâ refahı” konusundaki etik tartışmalara dikkat çekilerek, mevcut modellerin ahlaki açıdan acı çekebilen varlıklar olarak değerlendirilip değerlendirilemeyeceğinin henüz bilinmediği vurgulandı.
kaydırmaya devam ederek gündemden son dakika ve magazin haberlerine havadiskolik.com üzerinden anında erişebilirsiniz ve bizi twitter hesabımızdan takip etmeyi unutmayın ! https://x.com/havadiskolik

 News